고정 페이지 문서와 웹 페이지는 페이지를 반대 방식으로 설명하며 이것이 변환이 실망스러운 이유입니다.
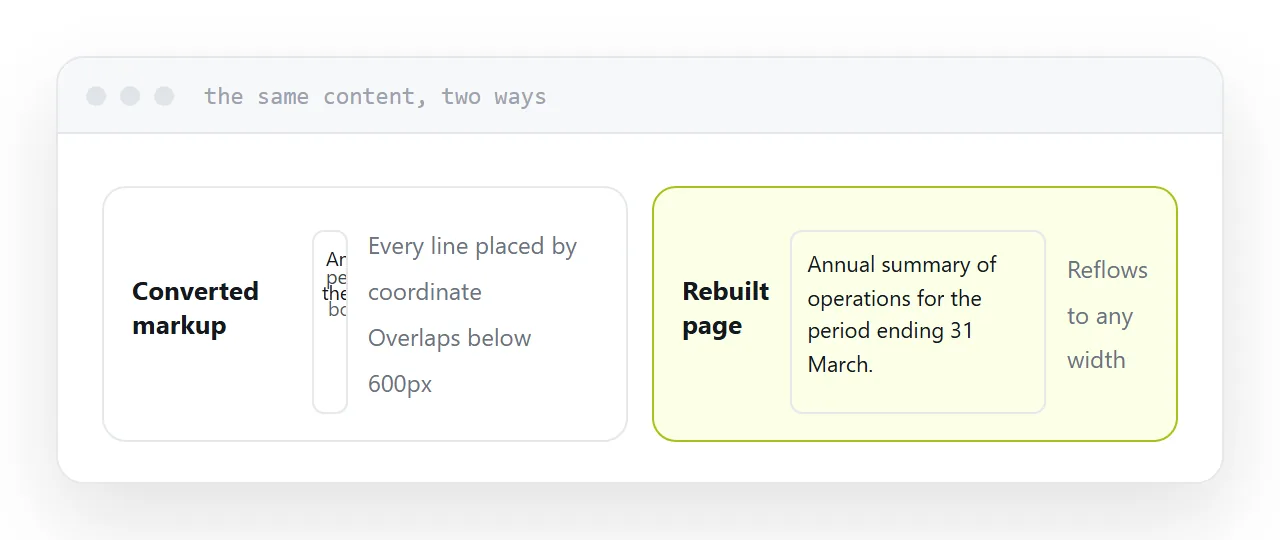
출력이 리플로우되지 않는 이유
고정된 문서에는 이 좌표의 이 단어, 이 글꼴, 이 크기가 나와 있습니다. 페이지는 고정된 직사각형이며 모든 것이 그 안에 배치됩니다.
웹페이지에 다음과 같이 나와 있습니다. 여기에 제목, 단락, 목록이 있습니다. 그들이 착륙하는 장소는 그것을 읽는 화면에 따라 결정됩니다.
변환기는 첫 번째에서 두 번째를 유추할 수 없으므로 모든 줄을 절대적으로 배치하여 모양을 유지합니다. 전체 너비에서는 올바르게 보이지만 휴대폰에서는 겹치는 선으로 축소됩니다.
출력은 기술적으로 마크업이며 페이지 사진처럼 작동합니다.
| 필요한 것 | 해야 할 일 |
|---|---|
| 재사용할 텍스트 | 텍스트 변환 및 복사 |
| 검색 가능한 버전 | 변환 후 정리 |
| 읽을 수 있는 페이지 | 텍스트에서 다시 작성 |
| 문서는 그대로 | 주소에 게시 |
| 스캔 | 먼저 인식 |
전환이 진정으로 도움이 되는 경우
텍스트를 꺼내는 중입니다.
고정된 문서에 잠겨 있는 보고서는 제대로 검색할 수도, 인용할 수도, 다른 내용으로 입력할 수도 없습니다. 변환은 텍스트를 자유롭게 하며 그 목적을 위해 잘 작동하고 시간을 투자할 가치가 있습니다.
결과를 완성된 페이지가 아닌 원시 자료로 취급하십시오.
테이블 및 스캔
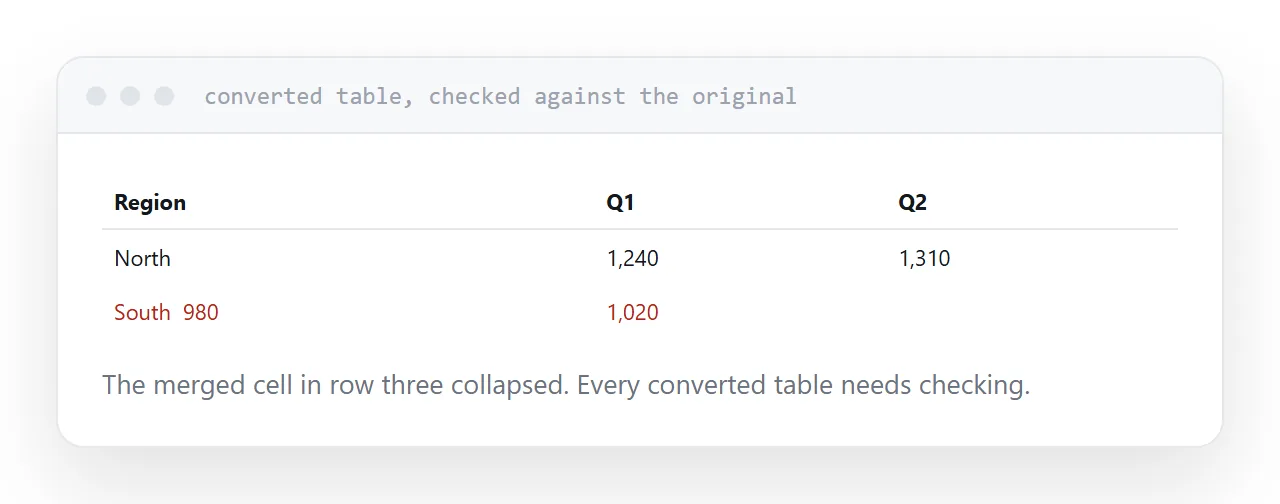
테이블은 가장 취약한 부분입니다. 고정된 문서에서 표는 좌표에 있는 선과 텍스트이며 표였다는 기록은 없습니다. 변환기는 근접성을 기준으로 이를 재구성하고 병합된 셀은 정기적으로 이를 무효화합니다. 변환된 모든 테이블을 원본과 비교하여 확인하세요.
스캔에는 텍스트가 전혀 포함되지 않습니다. 먼저 텍스트 인식을 실행한 다음 손으로 쓴 것, 대비가 낮은 것, 특이한 얼굴로 설정된 것 등을 변환하고 오류를 예상하세요.
사람들이 건너뛰는 옵션
종종 아무것도 변환할 필요가 없습니다.
누군가가 아무것도 다운로드하지 않고도 전화로 문서를 읽을 수 있도록 하는 것이 목표라면 특정 주소에 원본을 게시하면 이를 직접 달성할 수 있습니다. 브라우저에서 열리고 설계된 대로 정확하게 유지되며 구조가 추측되지 않았습니다.
변환은 다른 형태의 컨텐츠가 필요할 때를 위한 것입니다. 출판은 필요할 때 읽어야 합니다. 그것들은 별개의 문제이고 두 번째 문제는 일반적인 문제입니다.
주변 지면에 대해서는 AI가 생성한 HTML을 보기 좋은 PDF로 및 웹 페이지를 PDF로 저장하는 방법을 참조하세요.
주소에 넣어두세요
텍스트가 필요한지 아니면 읽을 수 있는 페이지가 필요한지 결정하고, 먼저 스캔 시 인식을 실행하고, 모든 테이블을 확인하고, 변환된 마크업을 배송하는 대신 다시 빌드하고, 읽는 것이 실제 목표일 때 원본을 게시하세요.